统计分析
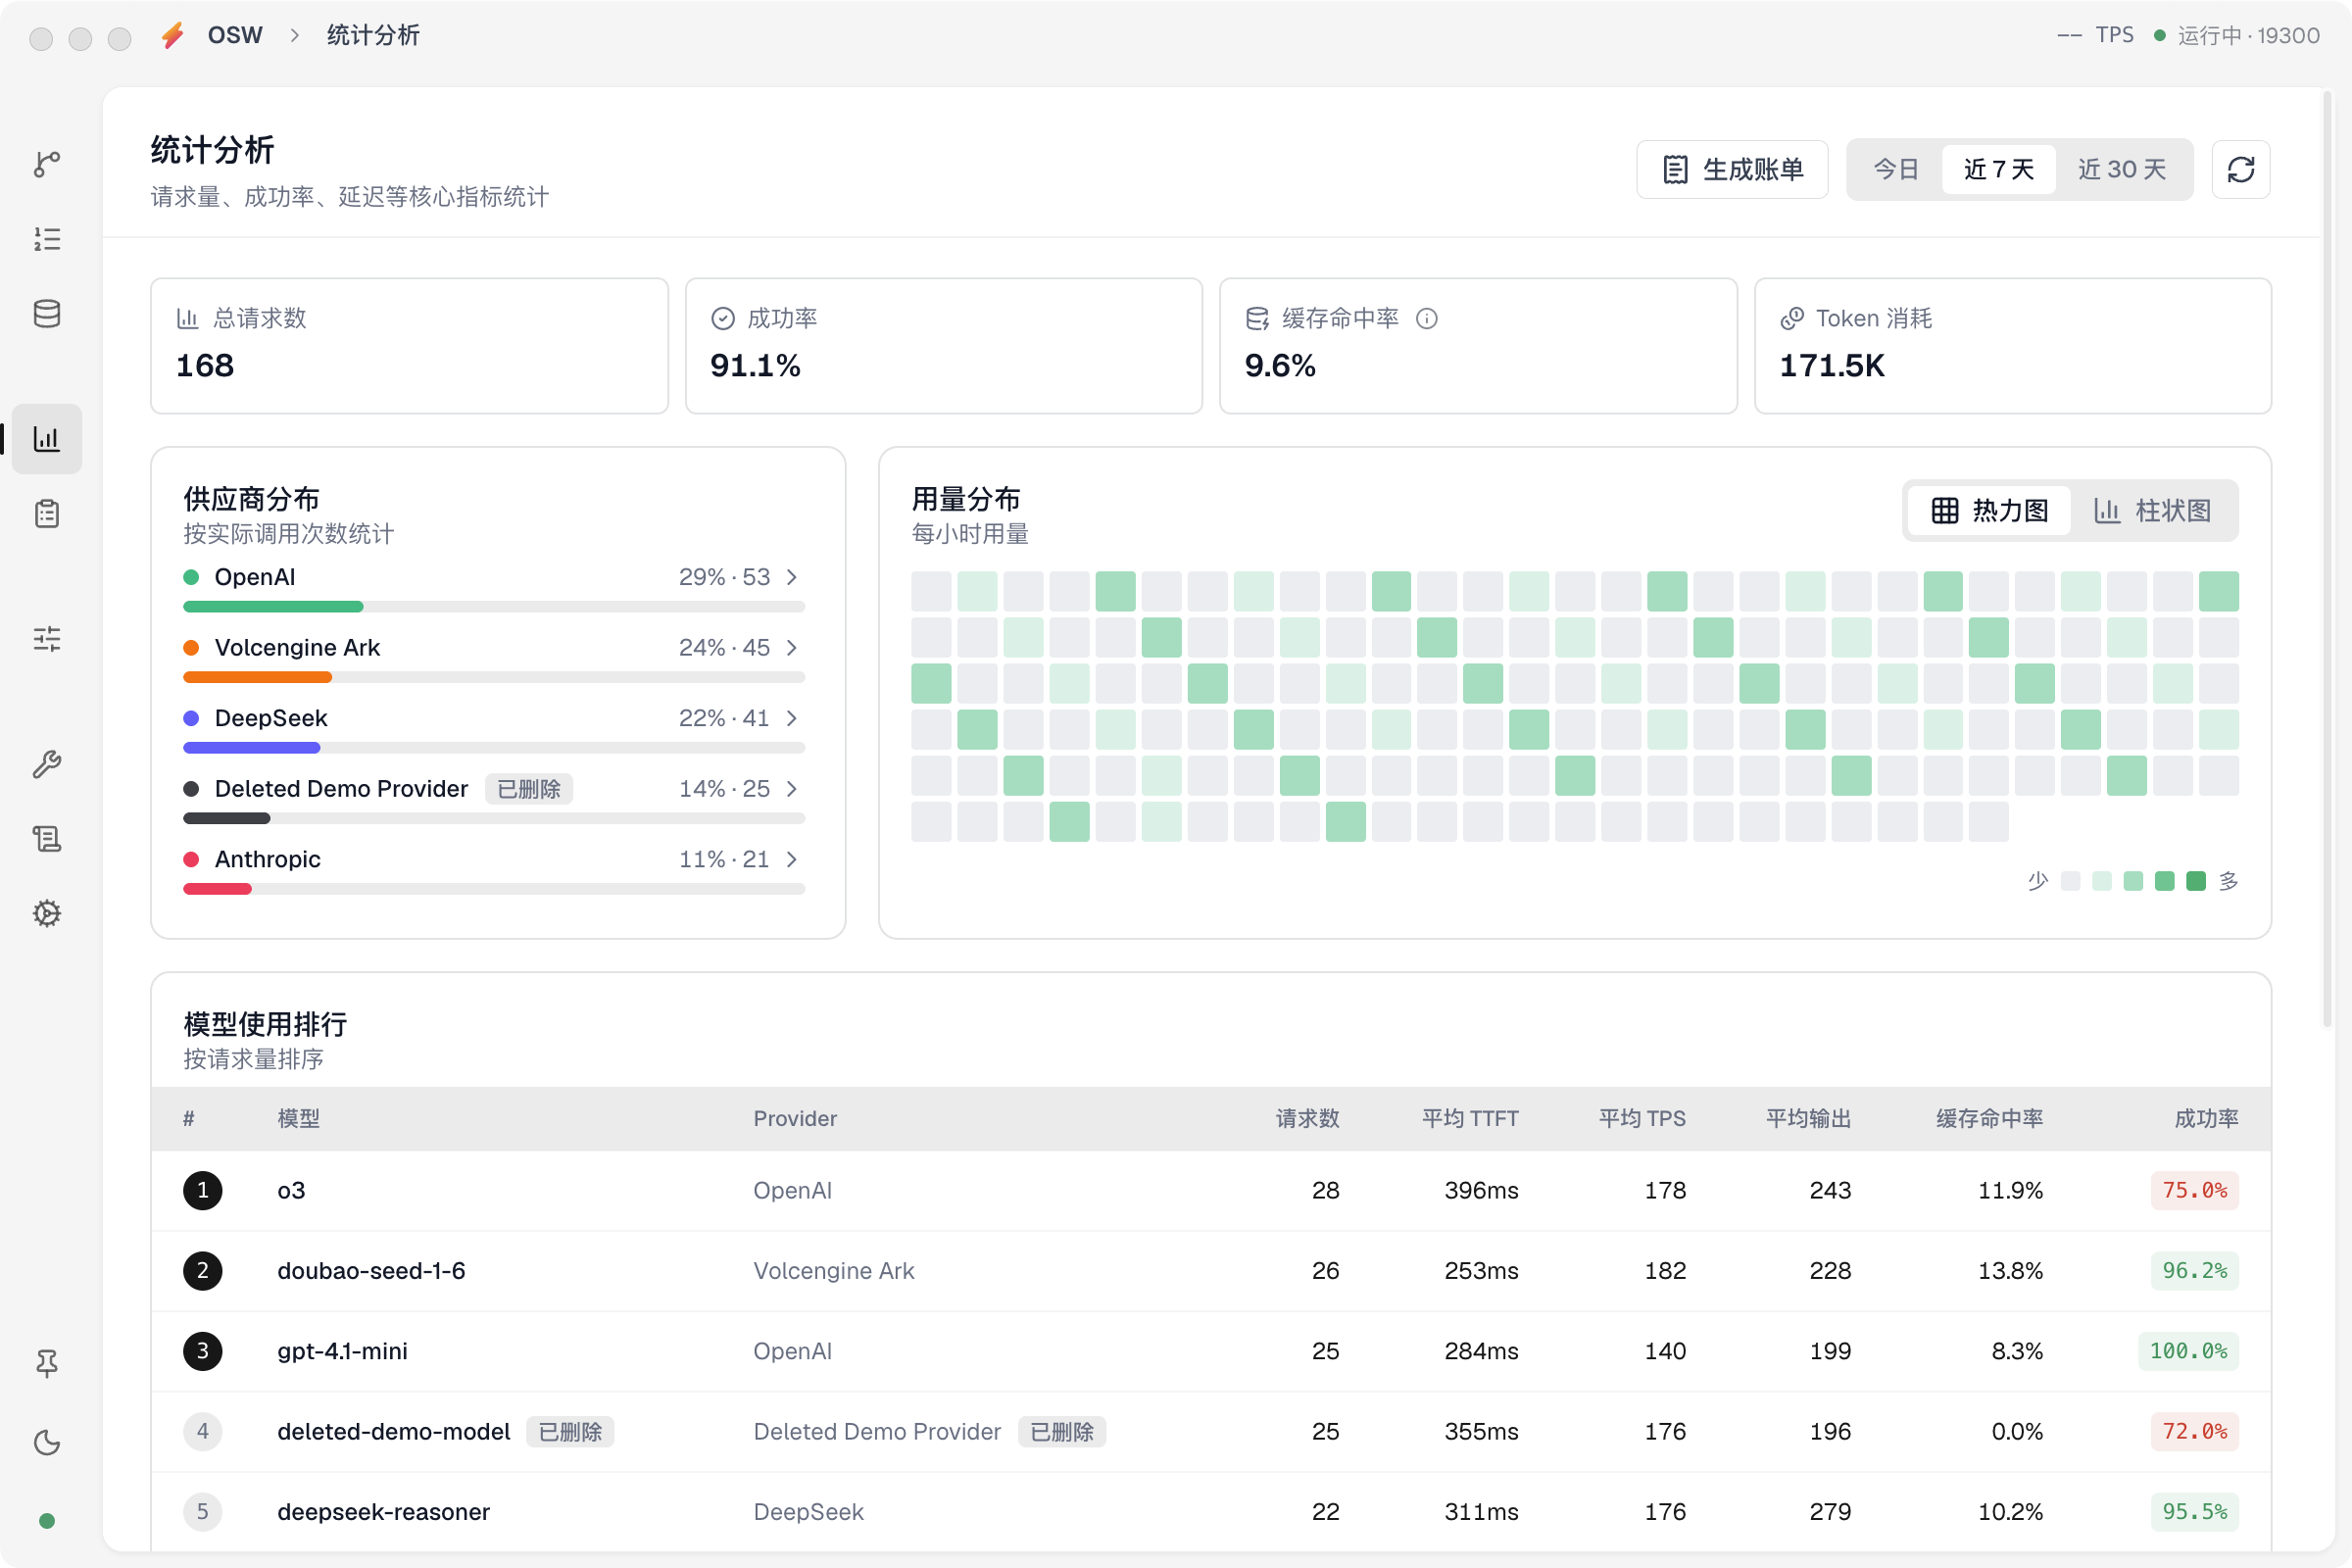
统计分析页把请求记录聚合起来看趋势,回答「这段时间整体跑得怎么样」。
指标概览
页顶的四张卡片是这段时间的总体结论:总请求数、成功率、缓存命中率与 Token 消耗;右上角切换统计范围(如近 7 天)。

用量分布
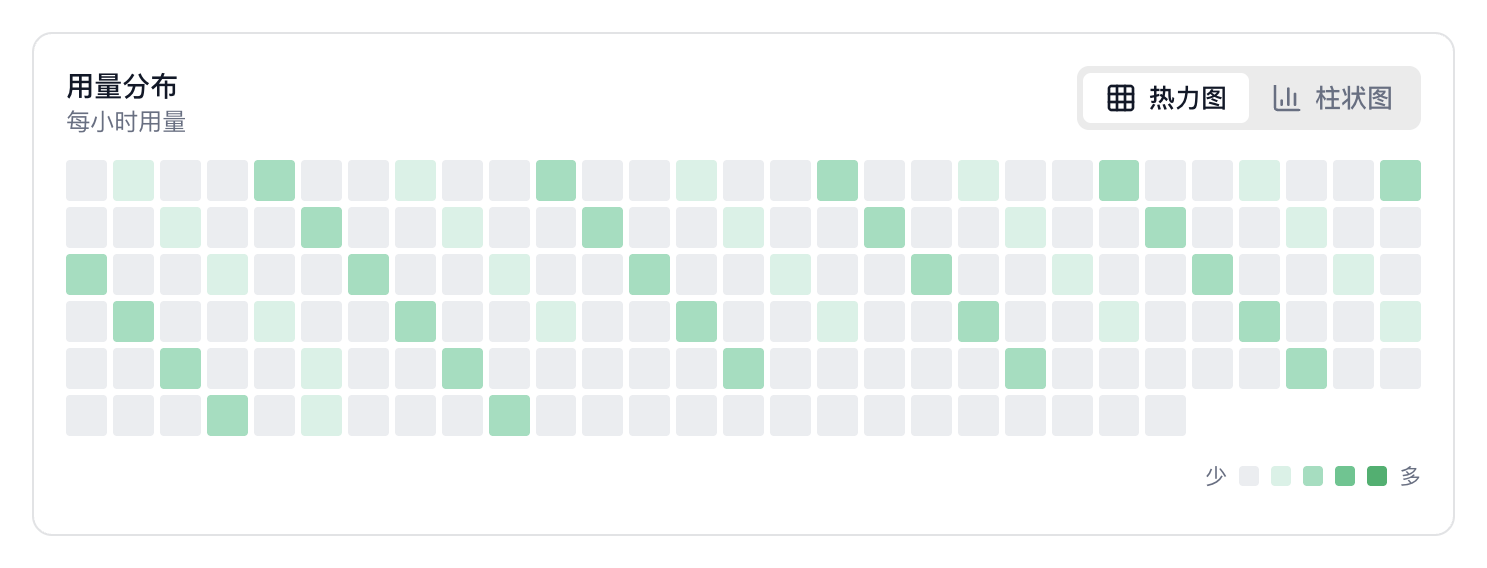
用量分布把请求量按时段摊开(热力图或柱状图可切换),一眼看出高峰在哪、哪段时间几乎没流量。用它交叉验证成本与限流问题:某个供应商的限流是不是总发生在你的高峰时段。
模型表排序
模型使用排行与供应商明细里的模型表,表头都可以点:点一下按这一列排序,再点一下反向。
- 首次点击的方向由列自己决定:请求数、平均 TTFT / TPS / 平均输出、缓存命中率、成功率这些数值列先看最大的;模型名与 Provider 名从 A 排到 Z。
- 没有样本的模型始终排在最后,升降序都一样——空的「平均 TTFT」不代表它最快。
- 名次跟着当前排序重排:按平均 TTFT 倒序时,第一名就是最慢的那个。排行榜只列前 10 名,但排序在全部候选里做,所以点一下平均 TTFT 能把请求量排不进前十的慢模型翻出来。
看什么
| 维度 | 用途 |
|---|---|
| 请求量 | 用在哪些模型、哪个客户端在用。 |
| 成功率 | 整体是否稳定。 |
| 耗时分布 | 响应是否变慢,慢在哪一段。 |
| Token 用量 | 用在哪个逻辑模型、哪个渠道上最多。 |
| 故障转移频次 | 哪个供应商在反复掉链子。 |
| 失败原因分布 | 超时 / 限流 / 5xx / 鉴权各自的占比。 |
与请求记录的分工
- 请求记录是逐条的,用来定位某一次请求发生了什么。
- 统计分析是聚合的,用来发现一段时间里的模式。
分析的是你自己的请求
这里的统计只来自本机的请求记录,与匿名使用统计是两回事。后者见本地优先与密钥。
排障思路
结合故障转移看,典型判断:
运行日志记的是服务自己在做什么,见运行日志。
